
Что проверить бизнесу при сбое Яндекса
Что проверить, пока внешний сервис недоступен, и после возвращения доступа? На примере заказов разбираем временную работу, достоверность показателей и план восстановления.
Короткий ответ. Пока внешний сервис недоступен, бизнесу нужно определить приоритетные операции и допустимый временный порядок работы. После возвращения доступа — сверить заказы, оплаты и данные, внесённые вручную, обработать очередь и подтвердить завершение временного режима.
Доступность сервиса, согласованность данных и возможность завершить операцию — три разных результата.
Что известно о сбоях Яндекса
Источники проверены 14 октября 2026 года.
В официальном сообщении Яндекса сообщается об остановке дата-центров в Сасове и Владимире и выходе из строя части инфраструктуры в Калуге 8–11 октября 2026 года. Компания сообщила, что пострадавших нет, а сроки восстановления оборудования оценить сложно.
В рекомендациях Yandex Cloud в редакции от 14 октября также нет сроков восстановления сервисов. Для решений о конкретных ресурсах следует использовать рекомендации провайдера и официальную страницу статуса: ограничения различаются между сервисами и ресурсами.
События такого масштаба ставят вопрос шире доступности одного поставщика: какую работу компания может продолжать, если внешняя система недоступна дольше обычного? Публичные сообщения не дают основания судить о полной архитектуре провайдера или о причинах отказа каждого ресурса. Зато компания может разбирать собственные зависимости и условия восстановления.
Почему доступ к сервису ещё не означает восстановление работы
Сообщение об устранении инцидента у поставщика описывает состояние его сервиса. В системах клиента в это время могут оставаться очереди, расхождения и операции, начатые другим способом. Поэтому возвращение доступа и завершение восстановления бизнеса требуют разных проверок.
Условный пример заказа, платежа и очереди событий
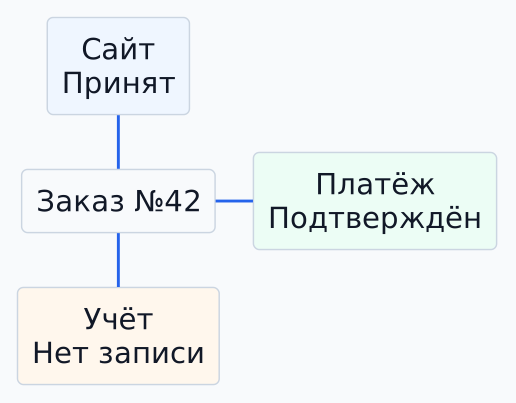
Представим компанию, у которой сайт принимает заказы, платёжный сервис подтверждает оплату, а внешняя интеграция передаёт заказ в учётную систему. Это условный пример, а не описание проекта RB Tech или конкретного инцидента у Яндекса.
Если интеграция недоступна, оплаченный заказ может ещё не появиться в учётной системе. После возвращения связи накопленные события начинают поступать, некоторые из них могут быть доставлены повторно. Простой повтор всех действий без сверки способен создать дубли или повторно запустить исполнение.
Восстановленной работой в таком примере будет не только доступность интеграции. Важно сопоставить принятые заказы, подтверждённые оплаты и записи в учёте, обработать очередь по согласованным правилам и отдельно разобрать исключения. Критерий завершения проверяет конкретную операцию, а не цвет индикатора.
На схеме сопоставлены состояния одного заказа в разных системах. Оранжевый блок показывает расхождение: платёж подтверждён, а записи в учёте ещё нет.
Какие решения нужны руководителю
Из примера следуют четыре предмета разговора с ИТ-командой. По каждому важно получить согласованный ответ: какую работу продолжаем, в каком режиме, на каких основаниях и кто подтверждает возвращение к норме.
Если подтверждённого срока восстановления нет, руководителю нужен момент следующего пересмотра решения: сколько ещё допустимо ждать, когда задействовать подготовленный резерв или альтернативный канал и кто сообщит об изменениях сотрудникам и клиентам. Возможность временной работы проверяют по условиям конкретной операции: например, можно ли принять заявку без подтверждения оплаты и какое обязательство при этом возникает. Перенос в другую среду тоже требует доступных данных, прав и проверки зависимостей.
Определить приоритетную операцию
Какую работу возвращаем первой и сколько она может ждать? Приоритет согласуют по последствиям задержки для клиентов и обязательств компании.
Согласовать временный порядок работы
Какие действия можно продолжать другим способом? Где фиксируют их состояние и как затем перенесут данные в основную систему?
Проверить основания для восстановления
Доступны ли копия, инструкция, права и ключи при отказе основной системы? Что уже испытали и сколько занял проверенный сценарий?
Назначить ответственного за сверку
Кто сопоставит заказы, оплаты и учёт, разберёт исключения и подтвердит завершение временного режима?
Где искать зависимость от внешнего сервиса
Внешняя система может хранить документы, принимать сообщения, рассчитывать маршрут или передавать события в учётную систему. Поэтому один и тот же сбой влияет на компании по-разному. Для одной остановится некритичная отчётность, для другой — подтверждение заказа.
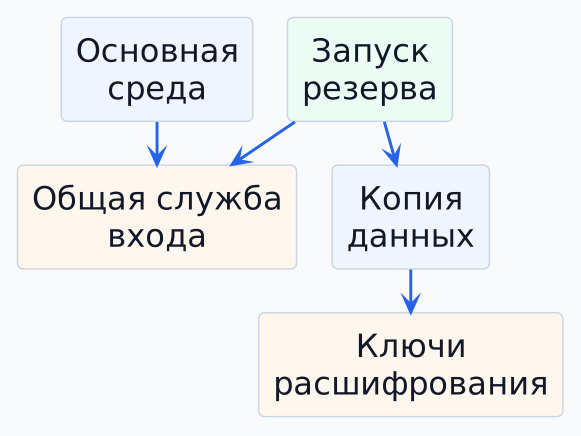
Условный пример: основная среда и запуск резерва зависят от одной службы входа. Если она недоступна, дополнительная площадка сама по себе не возвращает доступ. В этом примере резерв запускают из зашифрованной копии: нужны сама копия, ключи расшифрования и возможность ими воспользоваться. Наличие каждого ресурса проверяют в условиях отказа основной среды.
Зависимость бывает незаметна до отказа
Сайт может открываться, а заказ — не доходить до исполнителя. Сотрудники могут входить в систему, но не получать документ, без которого нельзя завершить работу. Мониторинг доступности отдельного приложения не отвечает на вопрос, выполнена ли операция от начала до конца.
Для руководителя предмет обсуждения здесь — конкретная функция и её допустимый простой. Формулировка «облако недоступно» слишком широка для решения: нужно понимать, какие действия остановлены, какие безопасно продолжать и где накапливается незавершённая работа.
Как читать показатели во время сбоя
В том же условном примере заявки могут продолжать поступать, пока передача данных в учётную систему остановлена. Тогда отчёт из этой системы показывает только часть операций. По нему одному нельзя заключить, что спрос или продажи упали: сначала нужно отделить остановку работы от задержки регистрации её результатов. Обратная ошибка тоже возможна — считать, что работа продолжается, только потому что сайт открывается.
Для управленческого решения важно указать, за какой период данные неполны и с какими доступными источниками их можно сверить. Журналы обмена с общими идентификаторами помогают найти пропуск или повтор, но не заменяют подтверждения оплаты и учётные записи.
После обработки очереди отчёт пересчитывают, если восстановленные данные это позволяют. Если часть событий утрачена и проверить её нечем, ограничение должно остаться в выводах; предположения не заменяют измерение.
Временная работа тоже требует возврата
Если во время сбоя заявки принимали другим способом, у компании возникает ещё один набор данных. Нужно понимать, как он попадёт в основную систему, кто проверит дубли и что произойдёт с действиями, которые нельзя автоматически повторять.
Такой порядок стоит связывать с документацией интеграций и эксплуатационной документацией. Тогда знания о состоянии операций, ограничениях повторной обработки и ответственных доступны команде сопровождения.
Бэкап, репликация и резервирование решают разные задачи
Эти механизмы дополняют друг друга. Они защищают разные свойства системы, поэтому один не стоит считать автоматической заменой другого.
| Подход | Что даёт | Чего сам по себе не подтверждает |
|---|---|---|
| Резервное копирование | Сохранённую версию данных для восстановления | Что копия доступна, пригодна и будет развёрнута вовремя |
| Репликация | Передачу изменений между копиями системы | Наличие чистой прошлой версии: ошибочное изменение тоже может распространиться |
| Резервирование | Дополнительные ресурсы или пути на случай отказа | Независимость от общей причины отказа и работоспособность переключения |
| Аварийное восстановление (disaster recovery, DR) | Подготовленный способ восстановить ИТ после серьёзного нарушения | Продолжение всей работы компании без организационных решений |
| Непрерывность бизнеса | Порядок продолжения приоритетной работы при нарушениях | Безусловное отсутствие простоя или потерь |
Копия данных и готовность восстановиться
Факт создания бэкапа отвечает на один вопрос: выполнена ли операция копирования. Для восстановления нужны дополнительные ответы: можно ли получить копию при недоступности основной системы, хватает ли прав и ключей, совместима ли она с подготовленной средой и проверялись ли целостность данных и рабочая операция при тестовом восстановлении.
Реплика помогает при отказе одного экземпляра, но её поведение зависит от настроек и сценария отказа. Резервный ресурс полезен, если доступен независимо от отказавшего и команда умеет им воспользоваться. Число площадок само по себе не показывает, что будет с общей службой доступа, сетью или внешним API.
DR и непрерывность бизнеса
Disaster recovery обычно переводят как аварийное восстановление. План аварийного восстановления (Disaster Recovery Plan, DRP) связывает технические действия с приоритетами, ответственностью и проверками. Непрерывность бизнеса шире: она включает людей, коммуникацию и временный порядок работы, пока ИТ восстанавливается.
Эти темы описывают ISO 22301:2019 для системы управления непрерывностью бизнеса и ISO/IEC 27031:2025 для готовности ИКТ к обеспечению непрерывности. Это ориентиры для построения системы управления; упоминание стандарта не доказывает готовности конкретной компании.
Здесь речь об операционной устойчивости: способности выдержать нарушение и восстановить работу. Она пересекается с информационной безопасностью, но отказ может быть вызван не только атакой — также технической аварией, ошибкой или недоступностью поставщика.
Почему план восстановления нужно проверять
План связывает технические средства с приоритетами, ответственными и критериями завершения. Учения показывают, насколько этот порядок выполним в выбранном сценарии.
Что означают RTO и RPO
Согласованные требования RTO и RPO помогают обсуждать восстановление предметно. RTO (Recovery Time Objective) — целевое время восстановления оговорённой функции. RPO (Recovery Point Objective) — допустимая глубина отката данных по времени: насколько старой может быть восстановимая точка относительно момента сбоя. Определения и подход к планированию, учениям и поддержанию плана приведены в руководстве NIST SP 800-34 Rev. 1.
Оба показателя требуют границ. «Восстановиться за четыре часа» может означать запуск базы, доступность приложения или возобновление приёма заказов. Это разные результаты. Пока не определены функция, начало отсчёта и критерий завершения, число трудно проверить.
Целевое значение ещё не является измеренным результатом или договорной гарантией. Испытание может показать, что получение доступа, подготовка среды или проверка данных занимает больше времени, чем ожидалось. Тогда приходится менять план, ресурсы или согласованный уровень обслуживания.
Учебное условие: временная регистрация заявок позволяет соблюдать график обработки не дольше четырёх часов. Тогда срок возврата приёма в системе выбирают с учётом этой границы. Возможность временно принимать заявки ничего не говорит о допустимой давности восстановимых данных — RPO согласуют отдельно.
Обработка накопившихся заказов может иметь отдельный срок. Это условный сценарий, а не норматив или обещание RB Tech.
Возврат сервиса и завершение сверки
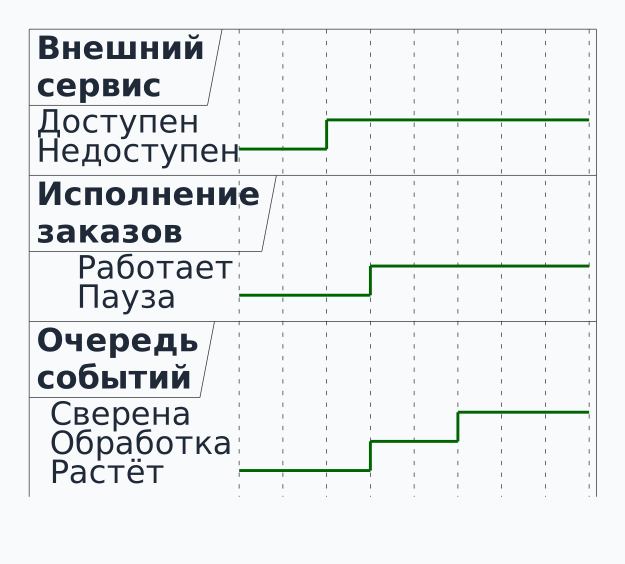
В условном примере заявки продолжают поступать другим способом, пока исполнение заказов приостановлено. После возвращения внешнего сервиса исполнение может возобновиться раньше, чем завершится обработка и сверка накопленного. Поэтому для возвращения выбранной функции и разбора очереди могут понадобиться разные критерии завершения.
Допустимый простой определяют по последствиям
У разных операций могут быть разные приоритеты. Приём обращений, расчёт зарплаты и подготовка управленческого отчёта не обязательно нужно возвращать одновременно. Анализ влияния на бизнес связывает очередность с последствиями задержки, обязательствами и допустимым временным режимом работы.
Универсального требования «RTO равен нулю» для любой системы нет. Даже если компания готова оплачивать минимальный простой, нужно проверить возможность такого режима для всей цепочки зависимостей, включая внешние услуги.
Что дают учения
Учения переводят предположения в наблюдаемый результат: доступна ли инструкция нужным людям, открывается ли резервная копия, работает ли подготовленная среда и сколько занимает возврат выбранной функции. Проверять стоит оговорённый сценарий с заранее определёнными границами и безопасными условиями.
Хороший документ сам по себе не заменяет такую проверку. В публичном разборе аварии GitLab 31 января 2017 года компания описала, как при восстановлении обнаружились проблемы с предусмотренными способами резервного копирования. В итоге использовали снимок данных, а часть изменений восстановить не удалось. Этот случай показывает ценность проверки фактической пригодности средств восстановления.
В документации AWS регулярная оценка и испытания также рассматриваются как часть стратегии DR. Более сложная резервная схема требует проверки; её сложность не является доказательством устойчивости.
Результат проверки относится к проверенному сценарию
Успешное восстановление одной базы не подтверждает готовность всей компании к потере площадки. Испытание в обычное рабочее время не показывает автоматически, что произойдёт при недоступности ключевого сотрудника. В отчёте полезны границы: что было отключено, какие зависимости оставались доступны, что восстановили и какие отклонения обнаружили.
Если команда сообщает, что работа восстановлена, полезно уточнить:
- Какая функция снова выполняется от начала до конца и когда это проверили?
- За какой период восстановлены данные, остались ли утраты, очереди или расхождения?
- Если заявлена готовность к повторному сбою, что именно испытали и какие зависимости оставались доступны?
Из этих результатов получается предметный следующий шаг: устранить конкретное ограничение, скорректировать целевое время или согласовать временный порядок работы. Требование «сделать надёжнее» становится набором объяснимых решений.
С чего начать обследование собственной системы
Если ответы о зависимостях и восстановлении разрозненны, начать можно с одной критичной бизнес-функции — например, приёма и исполнения заказа. Это даёт предмет обследования: какие системы участвуют в операции, где хранится её состояние и какие подтверждения восстановления есть у команды.
В RB Tech ИТ-аудит и техническое обследование включают анализ архитектуры, интеграций, инфраструктуры, резервного копирования, документации и рисков в согласованных границах. Для задачи восстановления до начала работ согласуем:
- Предмет проверки: выбранную функцию, участвующие системы и внешние зависимости.
- Основания для выводов: документацию, доступные сведения о резервировании и результаты проведённых проверок.
- Результат обследования: карту зависимостей, обнаруженные ограничения восстановления, приоритеты изменений и дальнейших проверок.
Внедрение, проведение учений и сопровождение согласуются отдельно. Обследование не позволяет обещать сроки восстановления чужой платформы; оно помогает определить решения и действия самой компании.
- Создано
- 13.10.2026
- Обновлено
- 19.10.2026
