
Инфраструктура и автоматизация
Как выбрать систему мониторинга ИТ-инфраструктуры и с чего начать
Создано 19.10.2026
Обновлено 19.10.2026
Как выбрать систему мониторинга серверов и ИТ-инфраструктуры? Разбираем первый состав, подключение логов и проверку доставки оповещений ответственному.
Короткий ответ
Систему мониторинга серверов и ИТ-инфраструктуры выбирают по тому, какие отказы нужно обнаруживать, откуда доступны данные и кто будет реагировать. Для начала нужны проверка доступности сервиса, состояние ресурсов, контроль резервного копирования и доставка уведомлений ответственному. Историю событий для диагностики организуют отдельной ветвью — через сбор и хранение логов.
Для виртуальных машин (VM), Proxmox и сетевого оборудования стоит проверить возможности Zabbix. Для приложений с числовыми метриками — Prometheus и нужные сборщики. VictoriaMetrics может стать хранилищем метрик, а Grafana — общим интерфейсом панелей. Устанавливать всё одновременно не требуется. Результат выбора — небольшой работающий контур с понятными проверками, владельцем и испытанием отказов. Такое руководство подходит перед первым внедрением или пересмотром существующего мониторинга; окончательные размеры и параметры определяют на своём потоке данных.
Какие задачи должен закрывать мониторинг
Начните с пользовательской операции: открыть личный кабинет, провести заказ, получить ответ API. Затем определите зависимости — приложение, база данных, сеть, виртуальные машины и резервное копирование. Так проще отличить отказ, требующий реакции, от изменения показателя, за которым достаточно наблюдать.
Проверки, метрики и логи
Проверка доступности отвечает, выполняется ли нужное действие сейчас. Метрика — числовой ряд во времени: частота ошибок, длительность запроса, занятая память. Лог сохраняет отдельное событие и его контекст. Распределённая трассировка связывает этапы одного запроса между сервисами. Эти сигналы полезны вместе, но каждый добавляет собственные затраты на сбор, хранение и разбор.
| Вопрос | Первый сигнал | Что проверить |
|---|---|---|
| Открывается ли сервис для пользователя? | Внешняя проверка HTTP или контрольной операции | Корректный результат, а не только ответ порта |
| Хватит ли ресурсов? | Метрики памяти, CPU, диска и очередей | Изменение во времени и влияние на работу |
| Почему запрос завершился ошибкой? | Логи с идентификатором запроса | Связь события с сервисом, временем и результатом |
| Где возникает задержка между сервисами? | Трасса запроса и метрики этапов | Передачу контекста между участниками |
| Можно ли восстановиться после отказа? | Статус копии и результат восстановления | Свежесть данных и фактический запуск восстановленной системы |
Логи нужны для разбора причин, поэтому их сбор и хранение разумно планировать вместе с мониторингом.
Если у сервиса есть мобильный клиент, для диагностики ошибок на устройстве и сервере учитывайте версию приложения и состояние синхронизации.
Что согласовать до установки
Составьте короткую карточку каждого критичного сервиса: владелец, часы работы, ключевая операция, зависимости, допустимое время обнаружения отказа и способ связи. Добавьте перечень уже установленных средств: возможно, нужные проверки можно включить в существующий Zabbix или облачный мониторинг.
Обнаружение отказа и доставка тревоги расходуют часть допустимого времени восстановления (RTO). На решение, восстановительные действия и проверку результата тоже должно оставаться время.
Уточните сетевые ограничения. Мониторинг может опрашивать источник либо получать данные от агента; выбранный способ должен работать через реальные межсетевые экраны и сегменты. Доступ на чтение метрик не должен автоматически давать административные права на приложение.
Новый стек не нужен, если действующий мониторинг уже покрывает согласованные отказы, хранит нужную историю и доставляет уведомления, а восстановление проверено. В таком случае полезнее закрыть конкретный пробел. Для контура с обязательными отраслевыми требованиями сначала уточняют эти требования и ограничения поставки; общего сравнения продуктов для допуска недостаточно.
Для каждого уведомления запишите получателя и ожидаемое действие. Например: при заполнении диска проверить скорость роста и освободить место по инструкции; при недоступности операции проверить зависимости и открыть инцидент. Для крупного отказа укажите условия запуска плана аварийного восстановления и роль, принимающую решение. Критичная тревога без получателя не становится полезнее от добавления панели.
Как выбрать Zabbix, Prometheus и другие компоненты
Сравнивайте состав решения, который придётся сопровождать: сбор данных, хранение, правила, интерфейс и доставку уведомлений. Одинаковое слово «мониторинг» в описаниях продуктов не означает одинаковый набор этих функций.
| Компонент | Когда рассматривать | Что входит в решение |
|---|---|---|
| Zabbix | Серверы, сеть, VM, типовые инфраструктурные проверки | Сервер, поддерживаемая БД, интерфейс; агенты, API или SNMP по источникам |
| Prometheus | Метрики приложений и хостов, обнаружение динамических источников | Сбор и хранение рядов, запросы, правила; необходимые exporters и Alertmanager для уведомлений |
| VictoriaMetrics | Подходящие требования к хранению метрик и Prometheus-совместимому доступу | Выбранная схема сбора, хранилище; отдельные правила и доставка уведомлений |
| Grafana | Общие панели по нескольким источникам | Подключения к хранилищам, панели и права доступа |
Когда начать с Zabbix
Zabbix уместно проверить первым, когда нужно наблюдать Linux/Windows, сетевое оборудование, гипервизор и прикладные службы по готовым интеграциям. Для Proxmox существует официальный шаблон интеграции. До установки убедитесь, что шаблон соответствует версии и доступным правам API.
У Zabbix есть и интеграция с Kubernetes, поэтому деление «Zabbix для старых серверов, Prometheus для всего нового» не помогает выбрать решение. Важнее полнота конкретных проверок и опыт команды. Его контроль строк журналов полезен для известных событий; общий поиск по полному потоку логов имеет отдельные требования к хранению и доступу.
Когда начать с Prometheus
Prometheus подходит, если приложение публикует метрики и команда готова поддерживать их названия, метки и правила. Для хостов используются exporters — компоненты, которые предоставляют показатели в нужном формате. Это применимо и к VM, а не только к Kubernetes. Архитектура сбора описана в документации Prometheus.
Проверьте количество рядов. Если меткой сделать идентификатор каждого запроса или пользователя, число комбинаций может быстро вырасти. Такие подробности обычно нужны в событиях, а не в метках метрик. Для отправки и группировки уведомлений в этой схеме используют Alertmanager. В Kubernetes можно оценить Prometheus Operator; устанавливать Kubernetes ради мониторинга нескольких VM не требуется.
Где нужны VictoriaMetrics и Grafana
VictoriaMetrics хранит метрики и может использоваться сразу либо подключаться к существующей схеме, например для приёма метрик по протоколу Prometheus remote write. Одноузловая версия умеет самостоятельно собирать метрики; отдельный vmagent выбирают по требованиям к сбору и маршрутизации. Это варианты архитектуры, а не обязательные последовательные установки. Возможности и ограничения сверяйте с документацией одноузловой VictoriaMetrics.
Grafana помогает собрать панели из разных источников. Для первого запуска может хватать интерфейса Zabbix, а для поиска событий — интерфейса VictoriaLogs. Наличие Grafana не заменяет хранилище данных и проверку уведомлений. Переход к общим панелям оправдан, когда команда понимает, какие решения принимает по каждой из них.
Что внедрять сначала и когда расширять контур
Первый этап должен обнаруживать согласованные отказы и доставлять сообщение человеку, который может действовать. Объём панелей и число продуктов выбираются после этого результата.
Минимальный рабочий состав
- Выберите несколько критичных сервисов и внешнюю проверку их работы.
- Подключите необходимые метрики хостов, приложения и хранилища.
- Настройте правила, получателей, повторные сообщения и завершение тревоги.
- Организуйте события для диагностики и контроль остановки их поступления.
- Проверьте отказ самого мониторинга из независимой точки.
- Зафиксируйте настройки, доступы, восстановление и владельца сопровождения.
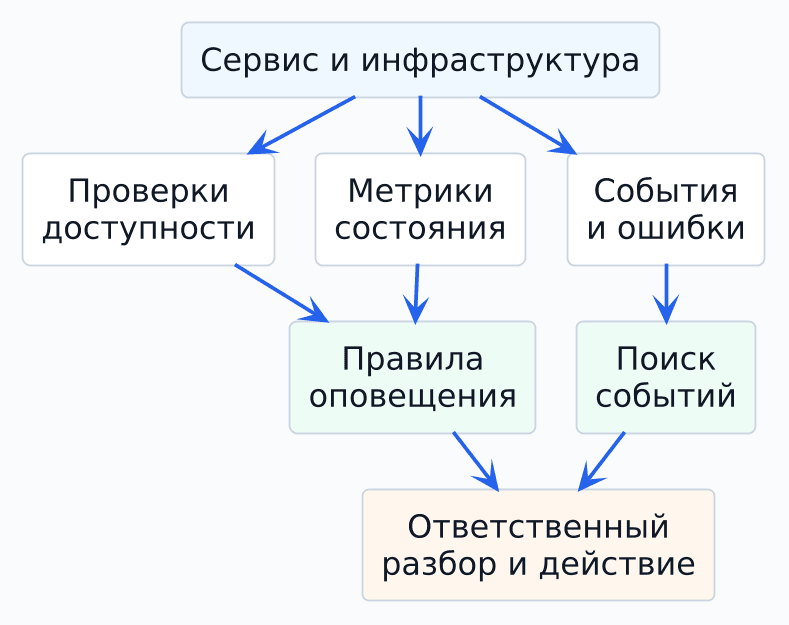
Разные сигналы сходятся в общую работу по разбору, но сохраняют свои хранилища и проверки. На схеме стрелки обозначают движение данных и уведомлений, а не порядок установки программ.
Что можно добавить позже
Общие панели Grafana добавляют, когда нужны представления для нескольких сервисов или команд. Более длительное хранение метрик — когда существующие сроки, объём или запросы перестали устраивать. Сначала измеряют поток и число рядов, затем выбирают хранилище и проверяют восстановление.
Трассировка полезна, если причину задержки приходится искать между несколькими сервисами. Для неё нужны инструментирование, передача контекста, выбор сохраняемых трасс и отдельное хранилище. Она не обязательна для каждой небольшой системы.
SIEM подключают под сценарии угроз и расследования. Wazuh и OpenSearch Security Analytics — возможные направления, но помимо установки нужны источники, нормализация, правила и ответственный за разбор. Обычный operational-мониторинг не закрывает автоматически эти задачи.
Отказоустойчивость и независимый архив обеспечивают сразу, если потеря узла недопустима. Возможность временно разместить компоненты в одной VM не означает, что они переживут общий отказ. Это ограничение следует включить в решение о запуске.
Как проверить выбранный состав на небольшом контуре
Пилот должен проверить конкретные отказы. Успешная установка и несколько графиков подтверждают только часть работы.
Условный пример с шестью VM
Предположим, компания использует один Proxmox-хост, шесть VM, веб-приложение и базу данных; Kubernetes отсутствует. Дежурный специалист работает с Zabbix. Разумный первый кандидат — Zabbix для инфраструктурных проверок, внешняя проверка пользовательской операции и отдельный сбор логов в VictoriaLogs через подходящий приёмник.
В этом примере существующий опыт уменьшает объём новой эксплуатации. Prometheus стоит добавить, если для приложения нужны метрики, которые удобнее поддерживать в его модели. До этого важно проверить, не хватает ли уже имеющихся средств. Grafana становится полезной при потребности в общей панели; сама по себе она не улучшает обнаружение отказов.
Остановка всего Proxmox-хоста отключит и VM с мониторингом. Поэтому внешняя проверка располагается за пределами этой общей точки отказа и доставляет уведомление независимым путём. Если требуется сохранять работу мониторинга при потере хоста, понадобится другая топология. Это условный проектный выбор, а не результат испытаний конкретной установки.
Испытания перед запуском
| Сценарий | Что должно произойти | Что сохранить как результат |
|---|---|---|
| Сервис остановлен | Ответственный получает тревогу в согласованное время | Время отказа, обнаружения и получения |
| Мониторинговая VM недоступна | Внешняя проверка обнаруживает отказ | Путь доставки сообщения и получатель |
| Диск быстро заполняется | Предупреждение приходит до остановки записи | Фактический запас времени при тестовом росте |
| Источник перестал передавать данные | Пропуск виден как неисправность сбора | Время последней записи и правило отсутствия данных |
| Сервис восстановлен | Тревога закрывается без необъяснимых повторов | Условие закрытия и история сообщений |
| Копия восстановлена | Проверяемая операция выполняется на восстановленных данных | Версия копии, процедура и результат проверки |
Порог должен оставлять время на действие. Одинаковые «80%» на всех дисках не учитывают скорость заполнения и возможность расширения. Интервал опроса и выдержку перед тревогой выбирают из допустимого времени обнаружения и обычных кратковременных колебаний. Итоговую задержку измеряют вместе с доставкой сообщения.
Типовые ошибки — наблюдать только за процессором, считать отсутствие данных нормой, отправлять одну тревогу из нескольких систем без разделения ответственности, размещать единственный канал обнаружения внутри наблюдаемого отказа и принимать закрытую тревогу за восстановление бизнес-операции. Для каждого случая нужен проверяемый результат, а не только исправленный график.
Что зафиксировать и как продолжить внедрение
На выходе нужен документ с составом компонентов, источниками, сроками хранения, правилами и владельцами. Приложите результаты испытаний, порядок обновления, резервного копирования и восстановления. Отдельно перечислите принятые ограничения: например, остановку поиска при потере единственной VM или отсутствие дежурства ночью.
Эти сведения входят в эксплуатационную документацию и пакет передачи проекта в поддержку.
Если непонятно, какие зависимости и отказы покрывает действующий контур, начать можно с ИТ-аудита и технического обследования. Если состав уже выбран, следующий шаг — согласовать проверки, реакцию и обслуживание в рамках сопровождения информационной системы.
Обсудить проект
Если хотите применить этот материал к вашему проекту, напишите нам. Поможем уточнить вводные, риски и следующий шаг: оценку, discovery, разработку, интеграцию или сопровождение.
СвязатьсяПредыдущая
Нагрузочное тестирование системыСледующая
Сбор и хранение логов