
Проектирование и оценка
Как определить RTO и RPO для бизнес-системы
Создано 14.10.2026
Обновлено 19.10.2026
RTO и RPO задают цели восстановления бизнес-системы. Показываем на примере, как согласовать время простоя, давность данных и критерии успешной проверки.
Короткий ответ
Чтобы определить RTO и RPO, выберите бизнес-функцию, оцените последствия её остановки и согласуйте две цели. RTO (Recovery Time Objective) — допустимое время от прерывания до восстановления выбранной функции. RPO (Recovery Point Objective) — допустимая глубина отката данных по времени: насколько старой может быть восстановимая точка относительно момента сбоя. Это требования, а не результат уже проведённых учений.
Зафиксируйте сценарий отказа, начало отсчёта, критерий завершения и ответственных. Техническая команда должна проверить достижимость целей с учётом копий, доступов и внешних зависимостей. Результат — согласованная карточка восстановления, по которой можно выбрать средства и подготовить проверку. Единого правильного значения для всех систем нет.
От какой работы отсчитывать простой
Границы задачи
Согласование нужно при проектировании системы, изменении её критичности, подготовке плана аварийного восстановления и пересмотре условий сопровождения. Выбирайте конкретную функцию: приём заказа, расчёт начислений, выдачу документа. Формулировка «восстановить весь ИТ за час» скрывает разные приоритеты.
Если требуется определить, как продолжит работать вся организация — с людьми, помещениями и коммуникацией, — одних RTO/RPO системы недостаточно. Для внешнего сервиса нельзя назначить срок восстановления, который вы не контролируете. Можно задать требования к собственной функции и допустимому обходному режиму.
Входные данные
- владелец процесса и технический ответственный;
- пиковые периоды, обязательства перед клиентами, последствия простоя;
- источники данных, расписание копий и результаты прошлых проверок;
- зависимости от входа, сети, ключей, интеграций и подрядчиков;
- доступный временный порядок работы и его ограничения.
Как выбрать цели восстановления
Сначала последствия, затем числа
Начните с вопроса владельцу процесса: что изменится, если система будет недоступна час, до конца рабочего дня или до следующего утра? Для выбора средств восстановления нужны конкретные последствия: какие обязательства нарушатся, какую работу можно временно продолжить и как долго хватит этого режима.
- Опишите, что перестаёт выполняться при выбранном отказе. Разделите недоступность интерфейса, задержку обмена и невозможность завершить операцию.
- Уточните, после какой длительности последствия становятся неприемлемыми. Учтите время обнаружения, решения, запуска, проверки и необходимые операции после запуска.
- Определите, данные за какой период допустимо восстанавливать из других источников, а какие операции нельзя повторить. Согласуйте RPO.
- Сопоставьте цели с реальной архитектурой, ресурсами и стоимостью. Если цели пока недостижимы, запишите ограничение и согласуйте с владельцем процесса следующий шаг.
Зависимости и деловые последствия рекомендует учитывать и AWS Well-Architected. Более строгие цели обычно требуют дополнительных средств; их выбирают по последствиям отказа.
RTO отличается от времени реакции поддержки. Время реакции определяет срок ответа или начала работ — как это описано в условиях сопровождения. RTO задаёт допустимое время восстановления функции. Быстрый ответ специалиста ещё не означает, что система снова выполняет операцию.
Запишите правила измерения
| Поле карточки | Что согласовать |
|---|---|
| Функция и сценарий | Название операции и сценария отказа |
| RTO и начало отсчёта | Допустимый интервал с отсчётом от прерывания функции |
| RPO и точка данных | Максимальная давность восстановимых данных относительно сбоя |
| Критерий завершения |
|
| Ограничения и владельцы |
|
Если обработка накопленной очереди и сверка входят в восстановление функции, их время включают в оценку. Если это отдельная работа после запуска, фиксируют отдельный критерий и срок. Иначе одинаковое число RTO будет означать разные результаты.
Как читать RTO и RPO на примере заказов
Учебный сценарий, не данные проекта. Приём новых заказов в системе прерывается в 10:00. Допустим, операторы могут до 12:00 записывать заявки в отдельный журнал; после этого временный порядок уже не позволяет соблюдать согласованный график обработки. Поэтому владелец процесса требует вернуть приём в системе к 12:00.
Отдельно владелец оценивает, какой объём операций команда сможет сверить и повторно внести по независимым подтверждениям. В этом учебном сценарии её возможностей хватает на записи за 15 минут; больший объём уже не укладывается в ресурсы смены. Поэтому согласована восстановимая точка данных не старше 09:45. Доступность подтверждений и возможность такой сверки нужно проверить.
| Параметр | Условное требование |
|---|---|
| RTO | 12:00 − 10:00 = 2 часа |
| RPO | 10:00 − 09:45 = 15 минут |
| Завершение | Новый тестовый заказ сохранён, виден оператору и получает подтверждение |
| После запуска | Ранее принятые заказы и подтверждения оплат сверяются отдельно; владелец и срок сверки указаны в плане |
Два часа на возвращение приёма и пятнадцать минут допустимой давности данных отвечают на разные вопросы. Готовность временно работать без приложения не означает согласия потерять все записи за это время. На схеме от одного момента сбоя отсчитываются два отдельных интервала.
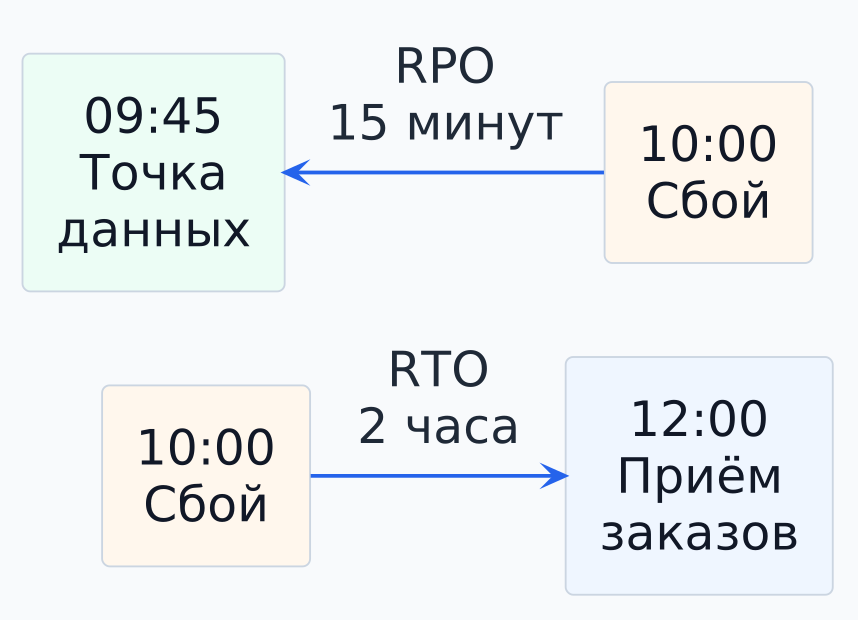
Эти значения не являются нормативом. Время создания файла копии само по себе не подтверждает точку восстановимости: важны состав, согласованность данных и возможность применить журналы изменений. Во время тестового восстановления сравнивают требование с фактически восстановленной точкой и временем выполнения операции.
Как понять, что цели согласованы
Типовые ошибки
- Приравнивать RPO к интервалу заданий копирования без проверки восстановления.
- Обещать RTO приложения, не учитывая недоступную авторизацию или внешний обмен.
- Считать RPO гарантированным объёмом безвозвратной потери. Часть операций иногда восстанавливают сверкой, но это требует отдельного времени и подтверждений.
- Выбирать нулевые значения без оценки достижимости и стоимости.
Что должно остаться после обсуждения
У карточки есть владелец, дата согласования, границы сценария и план проверки. Целевые RTO/RPO отделены от измеренных результатов. Непроверенные предположения видны. Карточку пересматривают при изменении функции, зависимостей, объёма данных или обязательств; периодичность плановых проверок назначают отдельно.
Что дальше
Перенесите цели в план аварийного восстановления и проверьте данные через тестовое восстановление резервной копии. Для описания общих зависимостей пригодится карта интеграций.
Если неизвестно, какие зависимости мешают согласованным целям, аудит ИТ-систем поможет обследовать архитектуру и ограничения. Реализацию резерва и учения согласуют отдельной задачей.
Методические ориентиры — NIST SP 800-34 Rev. 1 и публичная область применения ISO/IEC 27031:2025. NIST адресован федеральным ИС США; здесь он используется как руководство по планированию, а не как обязательная норма для российского проекта. Конкретные обязательства определяют применимые требования и договоры.
Обсудить проект
Если хотите применить этот материал к вашему проекту, напишите нам. Поможем уточнить вводные, риски и следующий шаг: оценку, discovery, разработку, интеграцию или сопровождение.
СвязатьсяПредыдущая
Архитектура CLI