
Сопровождение и развитие
Как выстроить процесс управления уязвимостями
Создано 28.09.2026
Обновлено 06.10.2026
Как выстроить управление уязвимостями: проверить применимость, учесть CVSS, EPSS и KEV, назначить устранение и подтвердить закрытие.
Короткий ответ
Управление уязвимостями — это повторяемый процесс, который превращает сигналы сканеров, проверок кода, тестирования и сообщений поставщиков в решения с ответственным, сроком и доказательством результата. Начать нужно не с покупки ещё одного инструмента, а с перечня систем и компонентов, правил проверки применимости и единого жизненного цикла находки. CVSS (Common Vulnerability Scoring System, система оценки характеристик и тяжести уязвимостей) помогает оценить техническую тяжесть. EPSS (Exploit Prediction Scoring System, система прогнозирования эксплуатации) показывает вероятность наблюдаемой эксплуатации опубликованной CVE в ближайшие 30 дней. CISA KEV (Known Exploited Vulnerabilities, каталог известных эксплуатируемых уязвимостей) фиксирует наличие подтверждённой эксплуатации. Но приоритет появляется только после учёта доступности компонента, критичности системы, возможного ущерба и действующих защитных мер. Закрывать находку следует после повторной проверки; неприменимость и принятый риск тоже требуют проверяемого основания.
Когда нужен управляемый процесс
Когда применять
Постоянный процесс нужен, когда организация эксплуатирует несколько систем, регулярно выпускает изменения или зависит от сторонних компонентов и инфраструктуры. Источники находок появляются с разной скоростью: сканеры инфраструктуры и контейнеров, SAST (Static Application Security Testing) — статический анализ безопасности кода, DAST (Dynamic Application Security Testing) — динамическое тестирование работающего приложения, SCA (Software Composition Analysis) — анализ состава программного обеспечения и зависимостей, security code review — экспертная проверка кода, тестирование на проникновение, сообщения поставщиков и внутренние инциденты. Без общего контура одна и та же проблема дублируется в нескольких отчётах, а действительно опасная находка может остаться без владельца.
Процесс особенно важен для доступных из интернета сервисов, систем с чувствительными данными, критичных рабочих операций и решений, где обновление нельзя установить немедленно. Он позволяет отделить технический сигнал от подтверждённой проблемы, сопоставить её с конкретным активом и выбрать реалистичное действие: обновление, изменение конфигурации, доработку кода, временную защитную меру или формальное принятие риска.
Когда достаточно разовой проверки
Разовая проверка допустима для ограниченного прототипа, изолированного компонента или конкретного изменения, если заранее известны версия, границы и решение, которое нужно принять. Но даже тогда нужен минимальный жизненный цикл: подтвердить применимость, назначить действие, проверить результат и сохранить вывод. Отчёт сканера без этих шагов не становится управлением уязвимостями.
Этот процесс не заменяет анализ безопасности кода, тестирование на проникновение или реагирование на инциденты. Они дают находки и контекст. Управление уязвимостями отвечает за то, что произойдёт с подтверждённым сигналом дальше.
Что подготовить до начала работы
Активы, версии и источники находок
Сначала нужен рабочий перечень активов: система, компонент, владелец, среда, поставляемая версия и критичность для деятельности. Полная инвентаризация всей организации может занять месяцы, поэтому первый цикл разумно ограничить одной системой, но внутри неё не пропускать зависимости, контейнерные образы, операционную систему, внешние сервисы и инфраструктурные компоненты.
Для собственных приложений полезны неизменяемые идентификаторы сборки, перечень зависимостей или SBOM — спецификация состава программного обеспечения. Для сторонних продуктов нужны точные названия, версии, каналы обновления и уведомления поставщиков. Источник сигнала сохраняют вместе с датой и исходными доказательствами, но не делают источником окончательного статуса.
Для контейнерной поставки фиксируют конкретный собранный образ по неизменяемому digest, а не только имя и тег: один и тот же тег может указывать на другое содержимое. Вместе с результатом сканирования сохраняют digest, дату проверки, название и версию инструмента, а также дату или версию использованной базы уязвимостей.
Один технический дефект нередко приходит из нескольких источников: CVE появляется в SCA, сканере контейнера и отчёте инфраструктуры. До постановки задач записи сопоставляют по активу, версии, идентификатору уязвимости и условиям проявления. Сопоставление не должно уничтожать исходные свидетельства: основная карточка хранит связи со всеми сигналами, чтобы при изменении описания CVE или результатов сканирования можно было восстановить решение.
| Источник | Что нужно подтвердить | Кто отвечает |
|---|---|---|
SAST или ручная проверка кода | Версию кода, достижимый путь и нарушенное свойство безопасности | Владелец приложения и разработка |
DAST или тестирование на проникновение | Контур, маршрут, предусловия и воспроизводимость поведения | Владелец системы и команда проверки |
SCA, SBOM или сканер образов | Наличие компонента в поставке, его версию и использование уязвимой функции | Разработка, платформа или эксплуатация |
Сканирование инфраструктуры | Актив, сетевую доступность, установленную версию и конфигурацию | Эксплуатация или владелец инфраструктуры |
Поставщик, БДУ или CVE | Совпадение продукта и версии, условия эксплуатации и доступное исправление | Владелец продукта или компонента |
Правила обработки, роли и границы решения
До первой очереди находок согласуют единые статусы, критерии приоритета и обязательные поля карточки. Минимально нужны владелец актива, ответственный за действие, срок, способ обработки, доказательство применимости, критерий повторной проверки и лицо, которое может принять остаточный риск. Разработчик не должен единолично принимать бизнес-риск, а служба безопасности — обещать дату релиза за команду продукта.
Полезно отдельно определить время реакции: когда сигнал должен получить первичный разбор, кто подключается к критичной находке и когда просрочка становится предметом управленческого решения. Это не обязательно единый срок для всех систем. Общую процессную рамку задаёт руководство ФСТЭК по организации процесса управления уязвимостями ↗, но конкретные интервалы зависят от критичности актива, доступности эксплуатации, требований договора и применимых нормативных документов. Срок должен быть объяснимым, а не механически перенесённым из чужого стандарта.
Нужно также определить границы процесса. В эту практику входят уязвимости собственного кода, зависимостей и связанной инфраструктуры конкретных систем. Полный корпоративный охват, выбор платформы сканирования, расследование активного инцидента и детальный регламент установки обновлений требуют отдельных решений.
Как проходит работа с уязвимостью
Проверка применимости
Первый вопрос — относится ли сигнал к реально используемому активу. Для CVE проверяют продукт, точную версию, наличие уязвимого компонента в поставленном артефакте, включённую функцию, конфигурацию и достижимость. Для дефекта собственного кода фиксируют сборку, маршрут, требуемую роль и нарушаемое свойство. Автоматическое совпадение по имени пакета или баннеру сервиса является поводом для разбора, а не доказательством эксплуатации.
Статус «не применимо» должен содержать проверяемое основание: ссылку на состав сборки, конфигурацию, результат контролируемой проверки или подтверждение поставщика. Формулировка «у нас это не используется» без версии и доказательства быстро устаревает. При следующем релизе или изменении конфигурации основание нужно пересмотреть.
Приоритет и способ обработки
Приоритет нельзя сводить к одному баллу. CVSS ↗ описывает характеристики и техническую тяжесть уязвимости. EPSS ↗ оценивает вероятность того, что эксплуатация опубликованной CVE будет наблюдаться в течение следующих 30 дней, но не учитывает ущерб именно для вашей системы. Официальный каталог CISA KEV ↗ фиксирует уязвимости с подтверждённой эксплуатацией. К этим сигналам добавляют локальный контекст: доступность извне, требуемые права, критичность актива, данные и операции, наличие компенсирующих мер и сложность восстановления.
FIRST публикует EPSS v5 ↗ с 15 июня 2026 года. При сравнении оценок, рассчитанных до и после этой даты, нужно учитывать смену модели: резкий сдвиг значения может отражать изменение методики, а не изменение самой уязвимости.
| Сигнал | Что показывает | Чего не доказывает |
|---|---|---|
CVSS | Технические характеристики и тяжесть уязвимости | Наличие компонента, локальный ущерб и срочность именно для вашей системы |
EPSS | Оценочную вероятность наблюдаемой эксплуатации CVE в следующие 30 дней | Техническую тяжесть, применимость и полный риск для организации |
CISA KEV | Подтверждённую эксплуатацию уязвимости в реальных атаках | Наличие уязвимого продукта в вашем контуре и конкретный ущерб |
Локальный контекст | Доступность, ценность актива, возможные последствия и защитные меры | Корректность исходной находки без технического подтверждения |
После оценки выбирают способ обработки: устранить первопричину, установить обновление, изменить конфигурацию, ограничить доступ, отключить функцию, добавить обнаружение попыток эксплуатации или принять остаточный риск. Временная мера должна иметь владельца, срок и условие отмены; иначе она незаметно становится постоянной.
Задача на устранение
Рабочая задача связывает техническую проблему и проверяемый результат. В ней указывают затронутый актив и версию, условия проявления, влияние, выбранное действие, ответственного, срок и критерий приёмки. Для зависимости недостаточно написать «обновить библиотеку»: нужно назвать целевую версию, проверить совместимость и убедиться, что сборка действительно использует исправленный компонент. Для кода нужен регрессионный тест или другой способ воспроизвести прежнее нарушение и подтвердить защиту.
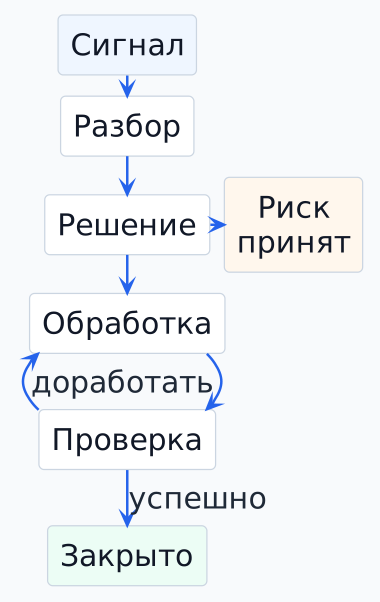
Если исправление сейчас невозможно, решение о принятии риска фиксирует основание, владельца риска, действующие меры, срок пересмотра и событие, после которого решение должно быть открыто повторно. Принятый риск — отдельный управленческий статус, а не более удобное название для просроченной задачи.
Повторная проверка и итоговый статус
Слияние изменения, установка пакета или комментарий исполнителя не закрывают уязвимость автоматически. Повторная проверка должна убедиться, что исходный путь больше не работает, нужная версия попала в целевую среду, соседние маршруты не оставили обход и допустимый сценарий не сломан. Для временной меры дополнительно проверяют, что она действует в реальном контуре и наблюдается средствами контроля.
Например, команда обновила Dockerfile и версии зависимостей, после чего сборка завершилась успешно. Это ещё не доказывает закрытие находки. Нужно пересобрать образ, получить его digest, проверить именно этот образ и убедиться, что в поставку или целевую среду передан тот же digest. Если проверен один образ, а развёрнут другой, находка остаётся неподтверждённо закрытой.
| Статус | Обязательное доказательство | Следующая проверка |
|---|---|---|
Подтверждено | Актив, версия, условия проявления и воспроизводимый результат | После выполнения назначенного действия |
Не применимо | Состав сборки, конфигурация или проверка, исключающая условия | При изменении версии, состава или конфигурации |
Компенсировано | Действующая мера, её охват, владелец и способ контроля | До отмены меры и после постоянного исправления |
Риск принят | Владелец риска, основание, срок и условия пересмотра | В установленную дату или при изменении контекста |
Закрыто | Результат повторной проверки на целевой версии или среде | Регрессионный контроль в следующих релизах |
Пример двух находок с разным приоритетом
Сканер сообщает о зависимости с высоким базовым CVSS. Разбор показывает, что компонент не входит в поставляемый артефакт, а уязвимая функция отсутствует в доступном пути. Находку можно признать неприменимой только после сохранения состава сборки и результата проверки. Высокий балл не требует имитации срочного исправления, но основание должно пережить смену исполнителя и повторный скан.
Другая находка имеет меньший CVSS, но относится к доступному из интернета сервису, обслуживающему критичную операцию. Есть сигнал известной эксплуатации, а дополнительных защитных мер нет. Такая проблема получает высокий локальный приоритет, конкретного владельца и короткий срок. Пример показывает, почему очередь нельзя сортировать только по одной колонке сканера.
Как контролировать качество процесса
Метрики, которые показывают состояние
Полезные метрики отвечают не на вопрос «сколько предупреждений нашёл инструмент», а на вопрос, управляется ли риск. Отслеживают долю активов с подтверждённым владельцем и версией, время от сигнала до разбора, количество просроченных подтверждённых проблем, долю закрытий с повторной проверкой, возраст принятых рисков и повторное появление уже устранённых классов дефектов. Отдельно полезно видеть очередь по критичным системам и находки с подтверждённой эксплуатацией.
Метрика должна вести к действию. Рост времени первичного разбора показывает нехватку ответственных или плохое сопоставление сигналов. Большая доля повторно открытых проблем указывает на слабые критерии приёмки. Накопление временных мер означает, что обходное решение перестало быть временным. Такие сигналы обсуждают с владельцами систем, а не используют как рейтинг отдельных разработчиков.
Количество открытых записей без контекста может расти после подключения нового источника и при этом означать улучшение видимости. Поэтому динамику объясняют вместе с охватом активов, качеством сопоставления и состоянием проверок. Цель процесса — не нарисовать ноль, а сокращать окно реальной уязвимости и сохранять доказуемые решения.
Типовые ошибки и ограничения
- Сканер принимают за процесс. Сигналы появляются, но у них нет владельца, решения и повторной проверки.
- Отчёт устарел или проверка не завершилась. Отсутствие свежих находок не означает успешную проверку: задача сканирования могла завершиться ошибкой, быть пропущена или не влиять на итоговый статус сборки. Так же нельзя закрывать находку только по факту изменения: исправление нужно проверить на целевой версии, включая отсутствие прежнего и альтернативного пути.
- Нет связи с активом. Команда обсуждает CVE, не зная, присутствует ли продукт и какая версия поставлена.
- Очередь сортируют только по CVSS. Теряются известная эксплуатация, внешняя доступность, критичность системы и защитные меры.
- Дубли считают разными проблемами. Несколько инструментов создают параллельные задачи с разными статусами.
- Исключение бессрочно. Ложное срабатывание или неприменимость не имеют основания и даты пересмотра.
- Принятый риск становится архивом. Нет владельца, срока и события, которое вернёт решение на пересмотр.
Процесс также ограничен качеством инвентаризации и доступностью доказательств. Если неизвестна фактическая версия или нельзя проверить среду, корректный статус должен отражать неопределённость, а не превращать предположение в факт.
Что должно получиться и что делать дальше
Артефакты на выходе и первый цикл
Рабочий результат — это не только реестр находок. Должны появиться перечень охваченных активов и версий, правила статусов и приоритета, карточки с доказательствами, очередь действий с владельцами и сроками, журнал принятых рисков, результаты повторных проверок и несколько метрик, по которым видно состояние процесса. Границы охвата и недоступные данные фиксируют рядом, чтобы отчёт нельзя было принять за полную оценку всей организации.
Начать можно с одной важной системы и 10–20 открытых сигналов из разных источников. Уберите дубли, подтвердите активы и версии, проведите каждую находку через применимость, решение и итоговый статус. Затем разберите, где не хватило владельца, данных или критерия приёмки, и только после этого расширяйте охват или автоматизацию.
Первый цикл стоит завершить коротким разбором процесса. Проверьте, какие данные пришлось искать вручную, где находка ожидала решения дольше всего, кто фактически подтвердил закрытие и какие исключения нельзя воспроизвести. По итогам обновите обязательные поля, роли и частоту контроля. Автоматизацию подключайте к устойчивому правилу: интеграция, которая быстрее создаёт неполные дубли, увеличит очередь, но не сократит риск.
Для подготовки состава системы, схем и доступов используйте практику «Что подготовить к ИТ-аудиту». Если нужно проверить не только очередь уязвимостей, но и качество кода, архитектурные ограничения и риски развития, сопоставьте процесс с материалом «Что проверять в аудите кода и архитектуры».
Обсудить проект
Если хотите применить этот материал к вашему проекту, напишите нам. Поможем уточнить вводные, риски и следующий шаг: оценку, discovery, разработку, интеграцию или сопровождение.
СвязатьсяПредыдущая
Надежность мобильного приложенияСледующая
Хранение и передача исходного кода